 OpenAI - ChatGPT, Sora
 Google - Gemini, Nano Banana
 Anthropique - Claude
 xAI - Grok
 Recherche profonde
 Alibaba - Qwen
 ByteDance - Le meilleur de ByteDance
 Tous les modèles
 Plans d'entreprise
 Développement d'applications d'IA
 API de traduction IA
 Service SEO/GEO IA
 Service de relations publiques géo-optimisé
 Service de web scraping
 OpenClaw
 Meilleurs outils d'IA
 Les meilleurs robots IA

 Se connecter
La puce Jalapeño d'OpenAI : Explication des mathématiques et de la technologie sous-jacentes
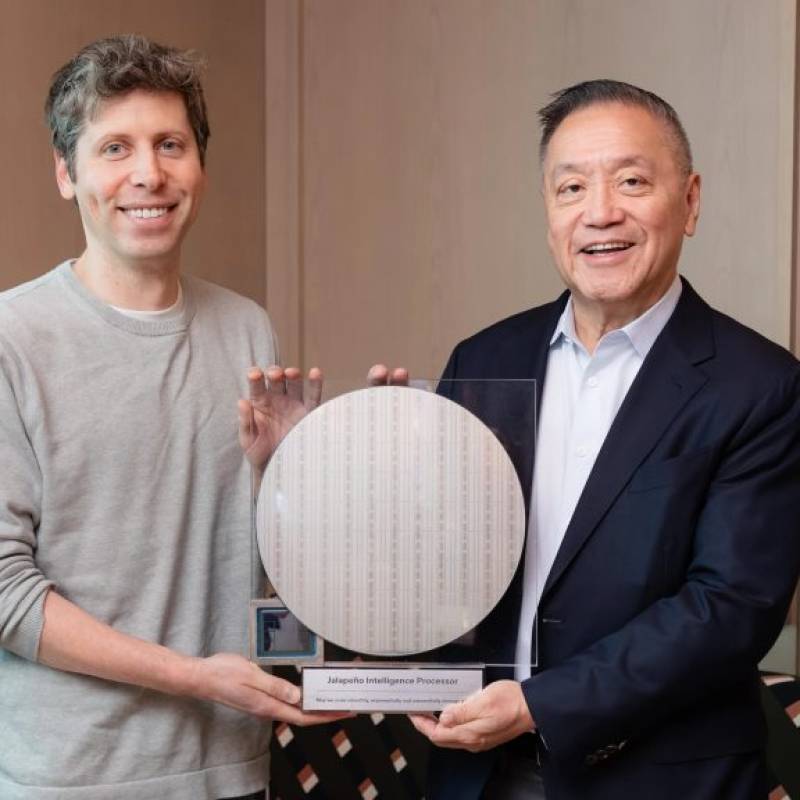
La trajectoire financière d'OpenAI dépend fortement de coûts d'infrastructure, une réalité qui a motivé le développement du nouveau Puce Jalapeño personnalisée OpenAIDéveloppé en collaboration avec Broadcom, le circuit intégré spécifique à une application (ASIC) représente une tentative directe d'atténuer les dépenses d'investissement importantes associées au matériel tiers.
Alors que Nvidia détient actuellement un chiffre d'affaires estimé marge bénéficiaire de 75 % Sur ses processeurs haut de gamme, OpenAI fonctionne avec des marges plus faibles, conservant environ 33 centimes de profit pour chaque dollar généré Après prise en compte de ses coûts opérationnels considérables, le fardeau financier lié à l'exécution de grands modèles de langage à grande échelle est lourd.
L'année dernière, maintenir la réactivité des serveurs ChatGPT a coûté à OpenAI une somme astronomique. 8,4 milliards de dollars américainsLa plateforme attire désormais 900 millions d'utilisateurs hebdomadaires, dont les coûts opérationnels devraient atteindre environ 14 milliards de dollars américains cette année.
Au cours des huit prochaines années, OpenAI s'est engagée à verser environ 1 400 milliards de dollars américains investis dans la puissance de calcul, un pari colossal pour une entreprise qui génère actuellement 25 milliards de dollars de revenus annuels.
🔧 Conception matérielle pour l'inférence LLM
Le Puce OpenAI Jalapeño, qualifiée de première de l'entreprise « Processeur de renseignement », est conçu spécifiquement pour l'inférence de grands modèles de langage (LLM) plutôt que pour les charges de travail d'IA à usage général. OpenAI a fourni la conception architecturale de base en s'appuyant sur ses feuilles de route de modèles et ses systèmes de déploiement spécifiques, tandis que Broadcom a géré l'ingénierie des puces et l'intégration du réseau haute performance.
TSMC gère la production physique à Taïwan, et Célestica est chargé de concevoir les systèmes de cartes et de racks. Selon OpenAI, les premiers prototypes de laboratoire exécutent déjà des charges de travail de pointe, dont une non publiée. Modèle GPT-5.3-Codex-Spark, à la fréquence et à la puissance de production cibles.
Richard Ho, responsable du programme matériel d'OpenAI, a souligné que l'architecture minimise le déplacement des données L'objectif est d'optimiser l'utilisation réelle au plus près des performances théoriques maximales. Contrairement aux accélérateurs généralistes adaptés des charges de travail d'IA existantes, cette architecture équilibre spécifiquement les ressources de calcul, de mémoire et de réseau afin de résoudre les problèmes de transfert de données inhérents au service LLM interactif.
Pour y parvenir à grande échelle, la plateforme intègre La puce réseau Tomahawk de Broadcom directement dans la conception, permettant aux processeurs personnalisés de communiquer à travers des environnements de centres de données massifs et regroupés en clusters.
⚙️ Le volant d'inertie de l'intégration verticale
En intégrant des puces personnalisées, OpenAI passe du statut de simple couche logicielle à celui de entreprise d'infrastructures verticalement intégréeCette stratégie globale couvre l'ensemble du pipeline : architecture de la puce, noyaux logiciels, systèmes de mémoire, planification du réseau et couche application finaleÀ l'instar du couplage étroit entre le matériel propriétaire d'Apple et iOS, OpenAI peut désormais optimiser son infrastructure en fonction de ses feuilles de route internes précises en matière de modélisation.
Cette intégration alimente un volant d'inertie à fonctionnement continuL'amélioration de l'efficacité de l'infrastructure réduit les coûts de formation et de mise en service. Une mise en service plus abordable permet de proposer des produits plus performants et plus réactifs, ce qui stimule le nombre d'utilisateurs et les revenus, lesquels peuvent être réinvestis dans la prochaine génération d'infrastructures personnalisées.
🚀 Surmonter le désavantage du retardataire
En introduisant ses propres puces, OpenAI entre sur un marché où ses principaux concurrents ont passé près d'une décennie à développer du matériel propriétaire. Google a commencé à déployer ses unités de traitement tensoriel (TPU) en 2015 et contrôle désormais environ un quart de la capacité de calcul mondiale de l'IA en dehors de la chaîne d'approvisionnement de Nvidia.
Amazone a expédié plus de un million de ses puces personnalisées, tandis que Meta et Microsoft continuent de développer leur propre infrastructure.
« Jalapeño fait partie de notre stratégie d'infrastructure complète à long terme visant à rendre la puissance de calcul plus abondante », a déclaré Greg Brockman« En concevant nous-mêmes une plus grande partie de la pile technologique, nous pouvons fournir davantage d'intelligence avec une plus grande efficacité », a déclaré le président et cofondateur d'OpenAI.
Pour combler ce retard, OpenAI a accéléré la phase de développement. La puce OpenAI Jalapeño est passée d'une conception entièrement nouvelle à fabrication sur bande— la dernière étape avant la production physique — en seulement neuf moisLes équipes d'ingénierie ont respecté ce délai en utilisant les modèles de langage d'OpenAI pour automatiser et optimiser certaines parties du processus de conception matérielle.
Cela crée un boucle de rétroaction unique où les modèles proposés aux utilisateurs sont activement mis à profit pour construire l'infrastructure physique qui exécutera les itérations futures. Le déploiement initial du matériel dans les centres de données devrait commencer d'ici le fin 2026.
PDG de Broadcom Jarret Tan a confirmé que le déploiement se fera en parallèle avec les partenaires d'infrastructure, notamment Microsoft, afin de préparer l'intégration de centres de données à l'échelle du gigawatt.
(Photo par OpenAI)