 OpenAI - ChatGPT, Sora
 Google - Gemini, Nano Banana
 Antrópico - Claude
 xAI - Grok
 Búsqueda profunda
 Alibaba - Reina
 ByteDance - Lo mejor de ByteDance
 Todos los modelos
 Planes empresariales
 Desarrollo de aplicaciones de IA
 API de traducción de IA
 Servicio de SEO/GEO con IA
 Servicio de relaciones públicas geooptimizado
 Servicio de extracción de datos web
 OpenClaw
 Las mejores herramientas de IA
 Los mejores robots de IA

 Acceso
OpenAI Jalapeño Chip explica las matemáticas y la tecnología que hay detrás.
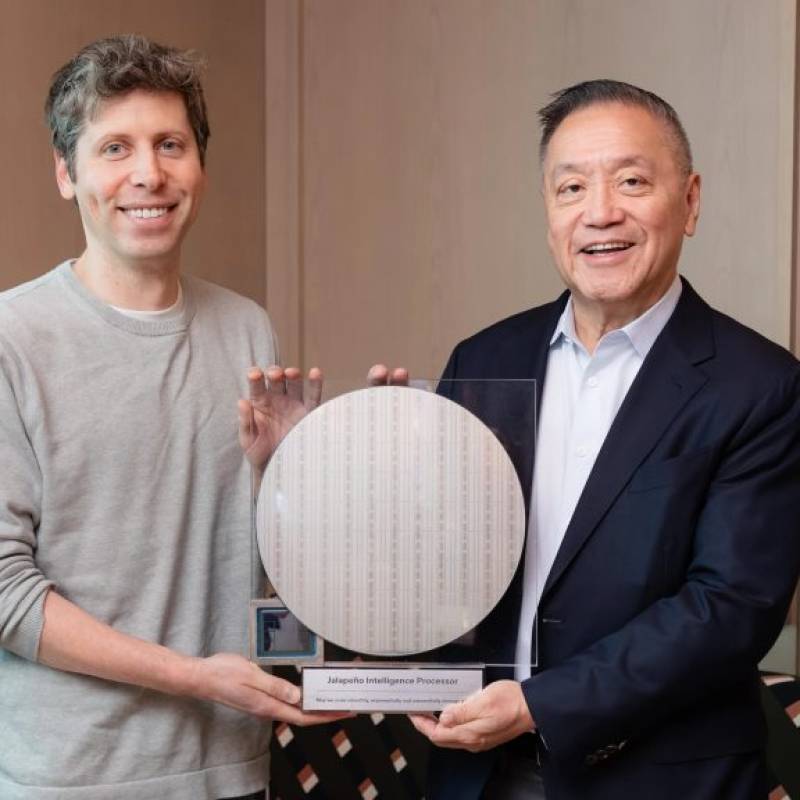
La trayectoria financiera de OpenAI depende en gran medida de costos de infraestructura, una realidad que impulsó el desarrollo de la nueva Chip de jalapeño personalizado de OpenAIDesarrollado en colaboración con Broadcom, el circuito integrado de aplicación específica (ASIC) representa un intento directo de mitigar el elevado gasto de capital asociado al hardware de terceros.
Si bien Nvidia actualmente controla una cantidad estimada Margen de beneficio del 75%. En sus procesadores de gama alta, OpenAI opera con márgenes más ajustados, manteniendo aproximadamente 33 centavos de ganancia por cada dólar generado Tras contabilizar sus enormes gastos operativos, la carga financiera que supone gestionar grandes modelos de lenguaje a gran escala es considerable.
El año pasado, mantener los servidores de ChatGPT en funcionamiento le costó a OpenAI una cantidad asombrosa. 8.400 millones de dólares. Ahora que la plataforma está atrayendo 900 millones de usuarios semanales, se proyecta que el costo operativo alcance aproximadamente 14 mil millones de dólares este año.
Durante los próximos ocho años, OpenAI se ha comprometido aproximadamente 1,4 billones de dólares estadounidenses para la potencia informáticauna apuesta enorme para una empresa que actualmente genera 25.000 millones de dólares en ingresos anuales.
🔧 Diseño de hardware para inferencia LLM
El OpenAI Jalapeño chip, denominado como el primero de la compañía "Procesador de Inteligencia"Está diseñado específicamente para la inferencia de modelos de lenguaje a gran escala (LLM, por sus siglas en inglés), en lugar de para cargas de trabajo de IA de propósito general. OpenAI proporcionó el diseño arquitectónico central basado en sus hojas de ruta de modelos y sistemas de servicio específicos, mientras que Broadcom gestionó la ingeniería de silicio y la integración de redes de alto rendimiento.
TSMC se encarga de la fabricación física en Taiwán y Celestica tiene la tarea de construir los sistemas de placas y bastidores. Según OpenAI, las primeras muestras de laboratorio ya están ejecutando cargas de trabajo de vanguardia, incluyendo una no publicada. Modelo GPT-5.3-Codex-Spark, a la frecuencia y potencia de producción objetivo.
Richard Ho, jefe del programa de hardware de OpenAI, señaló que la arquitectura minimiza el movimiento de datos para acercar la utilización real a su máximo rendimiento teórico. A diferencia de los aceleradores de propósito general adaptados de cargas de trabajo de IA heredadas, esta arquitectura equilibra específicamente los recursos de computación, memoria y red para resolver los cuellos de botella en el movimiento de datos propios del servicio LLM interactivo.
Para lograr esto a gran escala, la plataforma integra El silicio de red Tomahawk de Broadcom Integrado directamente en el diseño, lo que permite que los procesadores personalizados se comuniquen a través de entornos de centros de datos masivos y agrupados.
⚙️ El volante de inercia de la integración vertical
Al pasar a utilizar silicio personalizado, OpenAI pasa de ser una mera capa de software a una empresa de infraestructura integrada verticalmenteEsta estrategia integral abarca todo el proceso: arquitectura del chip, núcleos de software, sistemas de memoria, planificación de red y la capa de aplicación finalAl igual que Apple mantiene una estrecha integración entre su hardware propietario e iOS, OpenAI ahora puede optimizar su infraestructura en función de sus planes de desarrollo de modelos internos.
Esta integración alimenta una volante de inercia de funcionamiento continuoUna mayor eficiencia de la infraestructura reduce el costo tanto de la capacitación como de los modelos de servicio. Un servicio más asequible se traduce en productos mejores y más receptivos, lo que impulsa el volumen de usuarios y los ingresos, que se reinvierten en la próxima generación de infraestructura personalizada.
🚀 Superando la desventaja de actuar tarde
Al introducir su propio chip, OpenAI entra en un mercado donde sus principales competidores han dedicado casi una década al desarrollo de hardware propietario. Google comenzó a desplegar sus Unidades de Procesamiento Tensorial (TPU) en 2015 y ahora controla aproximadamente una cuarta parte de la capacidad de computación de IA global fuera de la cadena de suministro de Nvidia.
Amazonas ha enviado más un millón de sus chips personalizados, mientras que Meta y Microsoft siguen ampliando su propia infraestructura.
"Jalapeño forma parte de nuestra estrategia de infraestructura integral a largo plazo para hacer que la computación sea más abundante", dijo Greg Brockman, presidente y cofundador de OpenAI. "Al diseñar nosotros mismos una mayor parte de la infraestructura, podemos ofrecer más inteligencia con mayor eficiencia."
Para cerrar esta brecha en el cronograma, OpenAI aceleró la fase de desarrollo. El chip OpenAI Jalapeño pasó de un diseño completamente nuevo a diseño de la fabricación—el paso final antes de la producción física—en tan solo nueve mesesLos equipos de ingeniería lograron cumplir con este cronograma utilizando los modelos de lenguaje propios de OpenAI para automatizar y optimizar partes del proceso de diseño del hardware.
Esto crea un bucle de retroalimentación único donde los modelos servidos a los usuarios se están aprovechando activamente para construir la infraestructura física que ejecutará futuras iteraciones. El despliegue inicial del hardware en los centros de datos está programado para comenzar en el finales de 2026.
Director ejecutivo de Broadcom Hock Tan confirmó que el despliegue se ampliará junto con los socios de infraestructura, incluidos Microsoftpara prepararse para la integración de centros de datos a escala de gigavatios.
(Foto por OpenAI)